無関係な文脈による注意散漫
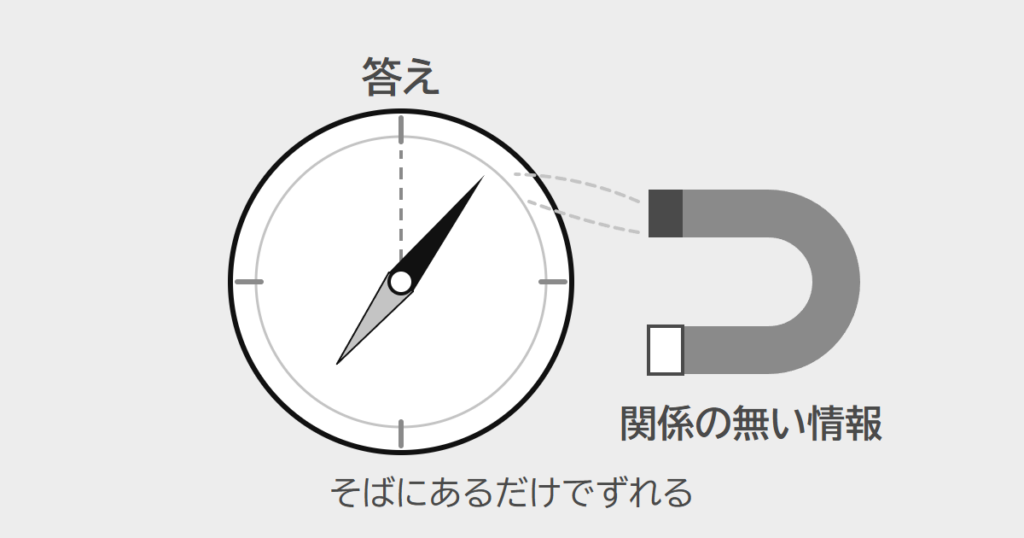
大規模言語モデル(AI)に渡す文に、答えに関係の無い情報が混じると、答えに必要な情報は同じでも、正しく答えられる割合が大きく下がる、という現象。
フレダ・シーらが2023年、小学校の算数の文章題に関係の無い情報を加えた問題集で確かめ、モデルの気の散りやすさ(distractibility)として示した。
2024年のイマン・ミルザデーらの研究でも、関係がありそうに見えて答えには使わない文言を1つ足すだけで、どの最先端のモデルでも成績が大きく下がった。
短い問題に足しただけでも起きるので、読める量を超えたかどうかより、その問いに使わない情報が混じることが引き金になる。
3つの例で見る
3つとも同じ骨組みです。答えに必要な情報は同じままでも、その問いに使わない情報が混じると、AIの答えは外れやすくなります。
研究の例
フレダ・シーらは2023年、小学校の算数の文章題に、答えに関係の無い情報を加えた問題集(GSM-IC)を作り、大規模言語モデルに解かせました。関係の無い情報が入ると、成績は大きく下がりました。関係の無い情報を無視するよう指示に書き添えるなどで、下がり方を和らげられるとも報告しています(フレダ・シーほか、ICML、2023年)。
算数の文章題に関係の無い情報を足すと、どうなるか。算数の文章題に関係の無い情報を足すと、必要な文は同じでも、外れた答えへの線が太くなる概念図。フレダ・シーほか「Large Language Models Can Be Easily Distracted by Irrelevant Context」(ICML、2023年)の要旨をもとにした概念図です。線の太さは模式で、論文の数値ではありません。
見分けにくい情報
イマン・ミルザデーらは2024年、数学の推論を試す問題に、関係がありそうに見えて答えには使わない文言を1つ足しました。それだけで、どの最先端のモデルでも成績が大きく下がり、下がり幅は最大65%でした(イマン・ミルザデーほか、2024年)。
答えに使わない文言が関係ありそうに見えると、どうなるか。数学の問題に、関係がありそうに見えて答えに使わない文言を足すと、外れた答えへの線が太くなる概念図。イマン・ミルザデーほか「GSM-Symbolic」(2024年)の要旨をもとにした概念図です。報告された下がり幅は最大65%で、線の太さは模式です。
職場の例え
社内のよくある質問にAIで答えるため、正社員とパートで違う休みの決まりを、両方まとめて渡したとします。パートの人に聞かれても、正社員の決まりが混じった答えが出やすくなります。誰からの質問かを先に確かめ、その人に当たる決まりだけを渡すと、混じる元が無くなります(例え)。
休みの決まりを両方渡すと、AIの答えはどうなるか。パートの人の質問に正社員の休みの決まりも渡すと外れた答えへの線が太くなり、外して渡すと正しい答えへ戻る、例えの概念図。例えの概念図です。実在の会社の出来事ではなく、線の太さは模式です。
今の AI の例は、下の「この概念・法則でニュースを読む」の記事で読めます。
この概念・法則でニュースを読む
T-Mobile、AIに読ませる文書を増やしたら答えが悪化。関係の無い資料が混じると外れる
なぜ?大きな文脈を読めるモデルにサポート文書を全部読ませれば専門家になると考えたT-Mobileで、なぜ答えはかえって悪くなり、うまく回り始めたのは客の望む手順を確かめてその手順の資料だけを渡すやり方だったのか
この記事からわかることAIに社内の質問を任せる前に、よく来る問いを言い方ごとに書き出して答えの元になる規程や手順書を1つずつ当て、1つの言い方に2つ以上の手順が当たるならAIに先に聞き返させて決まった側の資料だけを渡し、資料どうしで言うことが違うならどちらに従うかを人が決めてから渡し、決められないものは渡さない
どんなときに当てはまるか
AIに渡す文や資料に、その問いの答えには使わない情報が混じっているとき。混じった情報が、関係がありそうに見えるものでも起きる。
見分ける手がかり
資料や説明を足したのに答えが良くならない、または別の場面の決まりや手順で答える。問いはそのままで、使わない資料を外すと答えが戻る。
使うときに気をつけたいこと
資料は少ないほど良い、という意味ではない。答えに必要な情報が足りなければ答えはありきたりになるので、外すのはその問いに使わない情報に限る。人の注意が情報の多さで足りなくなる話(注意の希少性)とは、引き金が違う。
関連する概念・法則
注意の希少性 に似ている
どちらも、情報を足すほど受け取る側がうまく使えなくなる場面を扱う。注意の希少性は、情報が受け取る人の注意を使って届くことが引き金で、情報が増えるほど1つの情報に向けられる人の注意が減る、注意の量の話。無関係な文脈による注意散漫は、AIに渡す文に答えに使わない情報が混じることが引き金で、短い問題に関係の無い情報を足すだけでも正しく答える割合が大きく下がるので、読める量を超えたかどうかより、何が混じったかの話。受け取る人の注意が分けられて薄くなるのか、使わない情報が混じってAIの答えが外れるのかで2つが分かれる
この概念・法則の出典と記録
- 最初に観測した日
- 2026-11-21
- 出典
- Freda Shi・Xinyun Chen・Kanishka Misra・Nathan Scales・David Dohan・Ed Chi・Nathanael Schärli・Denny Zhou「Large Language Models Can Be Easily Distracted by Irrelevant Context」(ICML 2023、arXiv:2302.00093)/Iman Mirzadeh・Keivan Alizadeh・Hooman Shahrokhi・Oncel Tuzel・Samy Bengio・Mehrdad Farajtabar「GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models」(arXiv:2410.05229、2024年)