会社で使うAIエージェントは、自社の言葉の意味を知らないと、自信ありげに間違えます。何を売上と数えるか、どの顧客の記録が最新かといった意味です。そこで言葉の意味をまとめて管理する「定義の層」を作る企業が出てきました。米メディアVentureBeatの定点調査は、6月から8月にかけて、その取り組みとAIが実際に読む先を追っています。
この記事の要点
- 言葉の定義の層に取り組む企業は67%、AIの主な情報源にするのは13%
- AIが主に読むのは、文書の検索やシステムへの直接の問い合わせ
- 定義を作っても、AIが何を読むかは決まらない
- 定義を足す前に、AIの答えがどの資料から来たかをたどる
定義に取り組む人は増え、AIに読ませる人は減った。定義の層に取り組む回答者と、定義の層をAIの主な情報源に挙げた回答者を、6月から8月まで100人あたりの点で並べた図。数字は VentureBeat の定点調査 VB Pulse(2026年6月〜8月)の回答の割合を、100人あたりに置きかえたものです。
定義の層に取り組む企業は増え、主な情報源にする企業は減った
米メディアVentureBeatによると、企業のAIエージェントが自信ありげに間違える原因は、モデルより手前にあることがあります。何を売上と数えるのか、どの顧客の記録が最新なのかといった、その会社の言葉の意味をエージェントが知らないことです。
同社の定点調査VB Pulseは、企業がこの問題にどう対応しているかを、6月から3回にわたって追っています。3回とも、回答者の多くが、管理されたセマンティックレイヤー(言葉の意味を管理する層。以下、定義の層)を運用・試験・構築していると答えました。
一方で、その層を、エージェントが業務の文脈を得る主な情報源に挙げた回答者は、はるかに少数でした。自信ありげな誤答を、業務の文脈の欠落や不整合にたどった回答者は、どの回も半数を超えています。
| 回答 | 6月 | 7月 | 8月 |
|---|---|---|---|
| 定義の層を運用・試験・構築している | 58% | 63% | 67% |
| 定義の層をエージェントの主な情報源に挙げた | 21% | 19% | 13% |
| 過去6ヶ月の自信ありげな誤答を、文脈の欠落や不整合にたどった | 57% | 68% | 64% |
8月の調査では、エージェントが業務の文脈を主にどこから得るかの答えが分かれました。稼働中のシステムに直接問い合わせる経路は、7月からはっきり増えています。エージェントがSQLを実行したり、APIやMCPサーバーを呼んだりして、返ってきたものを読むやり方です。
| エージェントの主な情報源(8月) | 割合 |
|---|---|
| 文書の検索 | 32% |
| 稼働中のシステムへの直接の問い合わせ | 21%(7月は11%) |
| 大量の文書や記録を一度に読み込ませる | 19% |
| 定義の層 | 13% |
直接の問い合わせも、大量の文書を一度に読み込ませるやり方も、標準では管理された業務の定義を伴いません。どちらも定義の層と組み合わせられますが、回答者がそうしているかは調査から分からない、と記事は書いています。
さらに、自信ありげな誤答を報告した割合は、定義の層を運用・試験・構築している企業で78%、まだ検討中か予定の無い企業で37%でした。7月の別の回答者101人でも、89%対35%と同じ傾向が出ています。8月の報告書は、この差について2つの説明の可能性を挙げています。
- 見つけやすさ:誤答が多いのではなく、正しい定義と照らし合わせて多く見つけている
- 順序の逆転:文脈の失敗がすでにあった企業が、あとで層を作った
VB Pulseは、2つの群がなぜ違うのかを回答者に聞いていません。記事は、どちらの説明が当たっているのか、層が誤答の起きる率そのものを変えるのかは、調査では判断できないとしています。
定義を整える企業は増えたのに、なぜAIの主な情報源にならないのか
AIの誤答の一因が会社の言葉の意味にあるなら、定義をそろえるのは理にかなった対策です。実際に、定義の層に取り組む企業は回を追うごとに増えました。
ところが、その層をエージェントの主な情報源にする企業の割合は、回を追うごとに下がっています。誤答の原因を業務の文脈にたどる企業も、半数を超えたままです。
しかも、定義の層に取り組む企業の方が、誤答があったと答える割合も高くなっています。整えた定義は、なぜAIの読む先にならないのでしょうか。
定義は、AIが読む道筋の上に無ければ答えに入らない
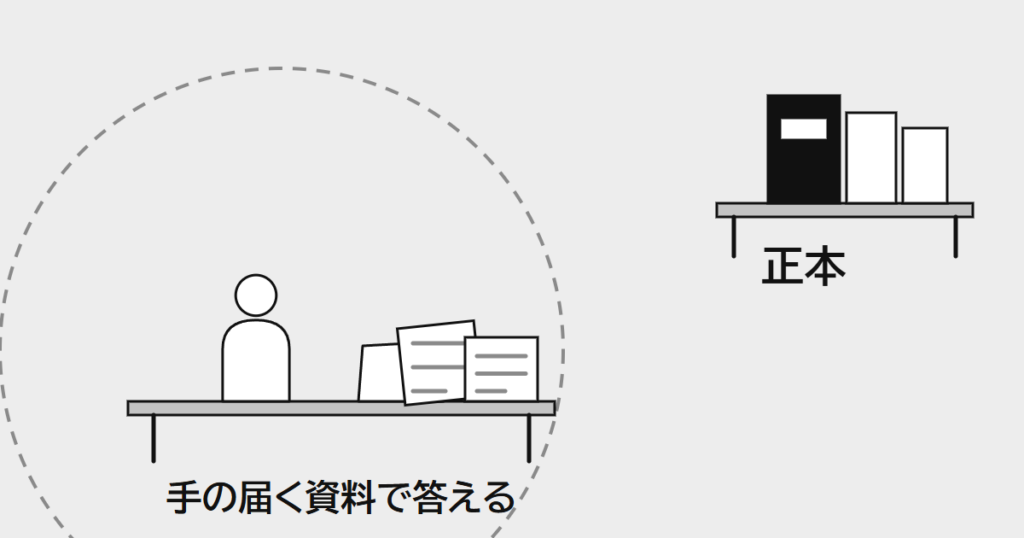
当サイトはこの構造を、「読まれない正本」という独自の仮説で捉えています。正本とは、言葉の定義や最新の台帳のように、会社が正しいと決めた元の情報です。観測はまだこの調査の1件だけです。
会社が正本を1か所に整えても、人やAIが答えを作るときに通る道筋の上に無ければ、答えはその正本ではなく、道筋の上にある資料から作られる。
今回の調査に当てはめると、正本は定義の層、道筋はエージェントが業務の文脈を得る経路です。8月には回答者の3分の2が定義の層に取り組んでいましたが、その中でも層を主な情報源に挙げたのは20%でした。
直接の問い合わせは、表の中身を返すだけで、その列が何を意味するかをエージェントに伝えないことがあります。経路が定義を通らない限り、整えた定義は答えに入りません。
定義を作る仕事と、AIの読む経路を作る仕事が分かれている
報道は、定義の層がなぜ主な情報源に選ばれないのかを伝えていません。エージェントがどの経路から読むかと、誤答の多さの関係も伝えていません。ここから先は、調査の数字に照らした推論です。
定義の層に取り組む企業が増える一方で、エージェントの経路は、標準では定義を伴わない直接の問い合わせへ広がっています。定義を整える仕事と、エージェントが情報を取りにいく経路を作る仕事が、別々に進んでいると考えます。VentureBeatは、記事の最後の節を次の一文で始めています。
セマンティックレイヤーを作っても、エージェントが何を読むかは決まらない。
定義の層に取り組む企業の方が誤答があったと答える割合が高い以上、定義を作れば誤答が減る、とは言えません。少なくともこの調査では、定義の層に取り組むことは、誤答の報告が少ないことと結びついていません。
製品の側では、エージェントが読む道筋の上で文脈を用意する動きが出ています。記事が挙げる3社のやり方は、それぞれ違います。
- Keewano:データを取り込むときに、イベントごとに文脈を付ける
- Snowflake:モデルがデータを探る前に、文脈を前もって用意する
- OpenAI:Data agentは常設の層を作らず、そのつど各所の文脈を集める
起きているのは定義の不足だけではなく、定義とAIが読む道筋のずれです。
定義を作り足す前に、AIの答えがどの資料から来たかをたどる
調査が扱うのは定義の層という大がかりな仕組みですが、同じずれは、仕組みを持たない会社でも起きると考えます。売上に何を含めるか、どの顧客台帳が最新かを決めた資料があっても、AIに渡しているのが別のファイルなら、AIはそのファイルをもとに答えを作るからです。
手順は、定義を作り足すことから始めません。答えがどの資料から来たかをたどり、その資料に自社の定義があるかで分けます。
- 売上や顧客など、自社の言葉が絡むAIの答えを1つ選びます
- その答えが、どのファイルや台帳から作られたかをたどります
- その資料に、自社の定義が書かれているかを確かめます
- 無ければ、定義をその資料か、AIへの指示に書き足します
書かれていれば、答えがその定義どおりかを照らし合わせられます。新しい定義を作るのは、AIが読む場所が決まってからです。
定義は、作った場所ではなく、AIが読む場所に置きます。
読み解きに使った概念・法則
読まれない正本
組織が言葉の定義や最新の台帳などの正本を1か所に整えても、人やAIが答えを作るときに通る道筋の上に無ければ、答えはその正本ではなく、道筋の上にある資料から作られる。
この記事で取り上げたニュース
その後の関連ニュース
更新の記録
- 2026-10-14、同じ構造をAIの回答に引用されるための企業の取り組みでも観測した(Motorwayは経営陣がAIの回答をリアルタイムで追い、新しく出した情報が24時間以内に引用されるのを確かめている。Floには、AIに見つけてもらうための専任の担当者がいる。Adweek)
- 2026-11-11、同じ構造をPayPalの社内の質問に答えるAIでも観測した(VentureBeatによると、AIは確かめたデータに届いていたが、社員が使う定義・データの引き出し方・分析の手順を足すまで業務の質問に確かに答えられず、足したあとはモデルを変えずに正答率が43%から95%に上がった。開発の流れでは、記憶を読むかをAIに任せず、決まった手順で必ず読ませた)
シェアする


 Googleで探しやすくする

関連記事
PRODUCT
注目ツール
直近、ニュースや活用事例、techtech.clubの記事などから話題のITツールを厳選しています。
EXPLORE
ほかのコンテンツも読む
気になるテーマに切り替えて、続きを探せます。
注目の企業
今日のニュース
身代金要求型の攻撃が増加、AIで詐欺メールも巧妙に
原文を読む(WIRED) ↗身代金を要求するサイバー攻撃(ランサムウェア)が、ここ数ヶ月で急に増えたと研究者はみています。犯罪者はAIを巧妙な詐欺メールの作成や交渉に使っています。日本では、AIで海外の攻撃者が説得力のある日本語の文面を作れるようになり、詐欺の被害が大きく増えています。完全に自動の攻撃はまだ現れていません。
Claude Opus 5.5、古い頼み方で応答が遅くなる
原文を読む(THE DECODER) ↗Anthropicは、有料プランの標準になったClaude Opus 5.5の頼み方の指針を公開しました。「よく考えて」などの指示を削ると、品質を落とさず応答が早く始まるとしています。推論にかける手間の設定は標準の「Medium」から始め、目的と出力の形を1回でまとめて伝えるよう勧めています。
AIチャットボット、買い物の質問に詐欺サイトを案内
原文を読む(Futurism) ↗Podqiの調査で、AIチャットボットが買い物の質問に、実在の店を装うサイトや偽物を売るサイトを示すことがありました。回答に占める割合はPerplexityが15%、ChatGPTが8%、Geminiが4%です。同社のCEOは、個人情報やカード情報を入れる前に出どころを確かめるよう勧めています。

仕事と組織の変化
職員約2万人の申請を紙からスマホへ
各社のIT活用
社員の情報でのカオナビの使い方
文章・資料づくりでのAzure OpenAI Service(IIJ GIO with Microsoft Azure)の使い方
ふくおかFGAzure OpenAI Service(IIJ GIO with Microsoft Azure)
- 文章・資料づくり
文書の下書きや企画のアイデア出し、マーケット情報の整理に、本部と営業店の約6,000人が使える社内の生成AIを使っている
同じ仕事の他社事例を見る →クラウド基盤でのAWSの使い方
- クラウド基盤
グループ5社の基幹システムを AWS の上に移し、システムどうしをつなぐデータHUBも AWS の上に作り、移行費用の償却後で従来より40%のコスト削減を見込む
同じ仕事の他社事例を見る →